Googleが発表した革新的なAIモデルGemini 3.5 Live Translateの技術的基盤と市場への影響を解説ます。
従来の音声翻訳が抱えていた遅延や誤差の問題を、音声を直接解析して生成するネイティブ音声対音声アーキテクチャによって克服し、話者の声のトーンや感情を維持したまま、70以上の言語で流暢な同時通訳を実現しています。
Google Meetやモバイルアプリでの実用的な展開に加え、開発者向けのAPI仕様やSynthIDによる透かし技術を用いた安全性についてもまとめました。
最終的に、この技術がビジネスや日常における言語の壁を根本から取り払う、次世代のコミュニケーション基盤としての役割を担うことを示唆しています。
1. イントロダクションおよび背景
2026年6月9日、GoogleはGemini 3 Proを基盤モデルとする新しい音声AIモデル「Gemini 3.5 Live Translate」を発表しました。
このモデルは、70以上の言語間でリアルタイムの音声対音声(Speech-to-Speech)翻訳を提供するものです。
Google翻訳の20周年(月間アクティブユーザー10億人超、サポート言語数250、月間翻訳文字数約1兆語)というマイルストーンを経て、音声翻訳技術は新たな次元に達しました。
日本市場においても、Google翻訳は2025年12月にGeminiモデルの導入による自然な音声翻訳を開始し、2026年3月27日には声のトーンやリズムを維持する「ライブ翻訳」を国内向けに提供していました。
今回のGemini 3.5 Live Translateのリリースは、これらを統合・拡張し、真の「同時通訳」に近い滑らかで途切れのない会話体験を実現する技術的ブレイクスルーです。
国内の主要なテクノロジーメディアも、このモデルを「同時通訳に近い音声モデル」や「AI同訳」と表現し、その即時性と自然さを極めて高く評価しています。
本報告では、この革新的な音声モデルのアーキテクチャ、技術仕様、開発者向けのAPI実装パターン、プラットフォーム展開、そして競合他社との戦略的比較について、詳細かつ体系的な分析を提示します。
2. アーキテクチャの革新:カスケード型からネイティブ音声対音声への移行
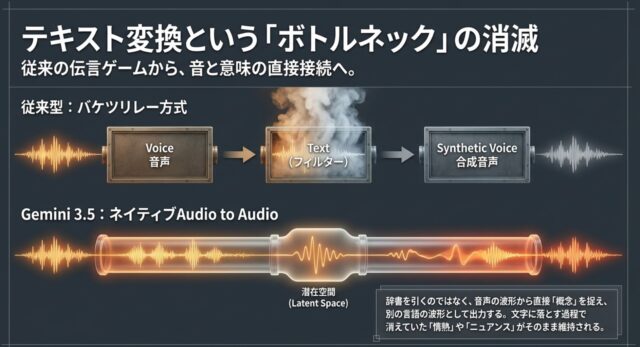
従来のリアルタイム音声翻訳システムは、複数の異なるモデルを直列に繋ぎ合わせる「カスケード型パイプライン」に依存していました。
この方式では、まずストリーミング音声認識(STT)モデルで音声をテキスト化し、そのテキストを機械翻訳(MT)モデルに投入し、最後にテキスト読み上げ(TTS)モデルによって翻訳音声を合成するという、3段階の処理を経る必要がありました。
このカスケード型システムには、システム工学的に2つの致命的な欠陥が存在しました。
第一に、各処理ステップで発生する遅延が累積し、会話の自然なリズムが遮断される「累積遅延問題」です。
第二に、前段のモデルが起こした認識ミスが後段にそのまま引き継がれ、最終的な翻訳結果でエラーが増幅される「エラー伝播問題」です。
Gemini 3.5 Live Translateは、音声入力を直接解析して翻訳後の音声をダイレクトに生成する「ネイティブ音声対音声」アーキテクチャを採用することで、この構造的ボトルネックを解消しました。
この一元化された音声生成アプローチにより、処理ステップ間のハンドオーバーに伴う無駄な遅延が圧縮され、発話開始からわずか数秒のレイテンシで翻訳音声が出力されます。
【従来のカスケード型パイプライン】
[話者音声] ──(STT: 音声認識)──> [中間テキスト] ──(MT: 機械翻訳)──> [翻訳テキスト] ──(TTS: 音声合成)──> [翻訳音声]
※ 各ステップで遅延が累積し、音響的なニュアンス(感情やイントネーション)はテキスト化の段階で完全に損失します。

【Gemini 3.5 Live Translate(ネイティブ音声対音声)】
[話者音声(16kHz PCM)] ───────────────> (Gemini 3.5 Live Translate) ───────────────> [翻訳音声(24kHz PCM)]
※ 単一のマルチモーダルモデル内で処理され、遅延を最小化すると同時に、話者の韻律情報(ピッチ、ペース、トーン)を直に移植します。
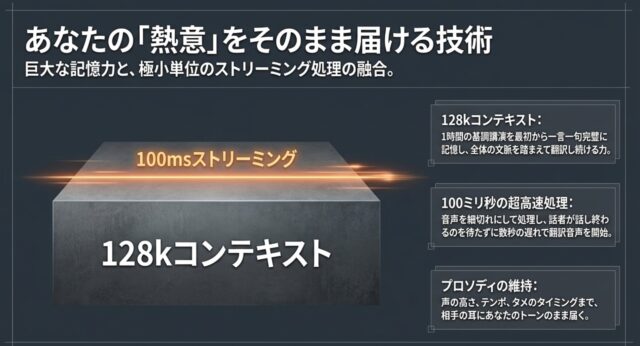
このアーキテクチャがもたらす最大の強みは、「韻律(プロソディ)の直接転送」です。
中間テキストを介さないため、話者の声の高さ(ピッチ)、発話の速度(ペース)、抑揚(イントネーション)、感情的な強弱といった非言語的特徴が、翻訳後の音声にも引き継がれます。
これにより、従来のロボットのような一律の機械音声とは一線を画す、極めて人間らしく、文脈に適した自然な対話が可能となりました。
さらに、本モデルは従来の「ターンベース(交互発話型)」の制約から脱却し、「継続的ストリーミング」処理を可能にしています。
システムは、話者が文章を完全に話し終えるのを待つことなく、リアルタイムに文脈の解釈と翻訳出力の生成を並行して行います。
コンテキストを十分に収集して翻訳品質を確保することと、遅延を最小限に抑えて発話者と同調することのトレードオフを高度に調停し、流暢な音声出力を維持する設計が施されています。
3. Gemini 3.5 Audioファミリーの機能比較
Googleは、音声翻訳向けのGemini 3.5 Live Translateに加えて、高度な音声文字変換に特化したGemini 3.5 TranscribeおよびGemini 3.5 Transcribe Liveを「Gemini 3.5 Audio」製品ファミリーとして同時展開しています。
これらは基盤モデルとしてGemini 3 Proを共有しつつも、異なる用途と入出力要件に最適化されています。
Gemini 3.5 Transcribeファミリーは、事前録音された音声ファイルのバッチ処理、またはライブでのテキスト書き起こしに最適化されており、自動言語検出(85以上の言語)、複数話者の分離(最大8名)、単語レベルのタイムスタンプ付与、さらには「えー」「あー」といった不要なフィラー(感嘆詞)の自動除去や、文脈に応じたアルファベット・数値のスマートフォーマット成形といった高度な構造化書き起こし機能を備えています。
これに対し、Gemini 3.5 Live Translateはリアルタイムの音声対音声翻訳(70以上の言語)に完全特化しており、ファンクションコーリングや検索グラウンディングといったAIエージェント向けの汎用機能は敢えて非搭載とされ、超低遅延を最優先した音声パイプラインとしてチューニングされています。
以下の表1に、Gemini 3.5 Audioファミリーに属する各モデルの技術仕様、およびサポートされている機能マトリクスを示します。
表1:Gemini 3.5 Audioファミリーの機能・技術仕様比較
| 仕様項目 | Gemini 3.5 Live Translate | Gemini 3.5 Transcribe (バッチ処理) | Gemini 3.5 Transcribe Live (ストリーミング) |
|---|---|---|---|
| モデルコード | gemini-3.5-live-translate-preview |
gemini-3.5-transcribe |
gemini-3.5-transcribe-live |
| 主な処理目的 | リアルタイム音声対音声の同時通訳 | 高精度な事前録音音声の文字変換 | リアルタイム音声の文字変換・字幕生成 |
| 対応言語数 | 70以上の言語(自動検出) | 85以上の言語(自動検出、コードスイッチ対応) | 85以上の言語(自動検出、コードスイッチ対応) |
| 最大入力ウィンドウ | 128K トークン | 96K トークン | 96K トークン |
| 最大出力ウィンドウ | 64K トークン | 32K トークン | 32K トークン |
| 音声ファイル制限 | ストリーミングのみ(バッチ処理非対応) | 最大1時間(高度機能有効時は最大30分) | 1セッションあたり最大10分 |
| 話者分離(Diarization) | 非対応 | 対応(最大8名、3名以上は実験段階) | 非対応 |
| タイムスタンプ付与 | 非対応 | 対応(単語レベル) | 非対応 |
| カスタムボキャブラリ | 非対応 | 対応(最大1,000語、推奨100語以内) | 対応(最大1,000語、推奨100語以内) |
| スマート dictation 機能 | 非対応(直訳と流暢さを重視) | 対応(フィラー除去、書式補正) | 対応(フィラー除去、書式補正) |
| 配信チャネル | API、Google AI Studio、Google翻訳、Meet | API、Google AI Studio | API、Geminiアプリ、AI Studio、Vertex AI、Search、Workspace |
4. API構成と開発者向け実装パターン
開発者が独自のリアルタイム多言語アプリケーションを構築する際、Gemini Live APIを介してgemini-3.5-live-translate-previewモデルへ接続することになります。
この通信は、全二重の双方向ストリーミングを可能にするWebSocketプロトコル上で行われます。
クライアント接続と音響パラメータ設定
通信の安定性と超低遅延を確保するため、音声ストリームは厳密なフォーマット制約に従わなければなりません。
入力音声は、16kHzモノラル、16ビットの符号付きリトルエンディアンPCM形式(audio/pcm;rate=16000)で、100ミリ秒単位の細かいデータチャンクとして連続送信されます。
モデルによって生成・合成された出力音声は、より高音質な24kHzモノラルのリトルエンディアンPCM形式で返されます。
{
  "setup": {
    "model": "models/gemini-3.5-live-translate-preview",
    "generationConfig": {
      "responseModalities": ["AUDIO"],
      "inputAudioTranscription": {},
      "outputAudioTranscription": {},
      "translationConfig": {
        "target_language_code": "ja",
        "echo_target_language": true
      }
    }
  }
}
設定オブジェクト内のechoTargetLanguageパラメータは、音声翻訳の運用ロジックを制御する上で重要です。
これをtrueに設定すると、ユーザーが既に翻訳先のターゲット言語(この場合は日本語)で話しかけた場合、モデルはその音声を解釈した上でそのままオウム返し(エコー)として合成・再生します。
一方、falseに設定すると、ターゲット言語と同じ入力音声に対してはモデルは応答を返さず沈黙を保ち、異なる言語の入力があった場合にのみ動作する仕様となります。
エフェメラルトークンを用いたクライアント保護
本モデルをiOSやAndroidなどのネイティブアプリ、またはフロントエンドのWebアプリケーションに直接実装する際、静的なAPIキーをアプリコードに埋め込むことはセキュリティ上、推奨されません。
この問題を解決するため、Gemini APIはバックエンドサーバーで一時的な接続資格情報を発行する「エフェメラル(一時的)トークン」の生成をサポートしています(v1betaエンドポイント)。
サーバー側でエフェメラルトークンを生成する際、live_connect_constraints(接続制約)を記述することで、クライアントがWebSocketを接続した際の設定変更を事前に「ロック」できます。
例えば、特定のユーザーに対して翻訳先を日本語(ja)に固定させ、改ざんを防ぎたい場合は、トークン生成時に翻訳設定を埋め込み、ロック指定を行います。
逆に、クライアント側で動的に翻訳言語を切り替えたい場合は、translationConfigを設定項目から除外し、lock_additional_fieldsを空([])にしてトークンを発行することで、フロントエンド側で自由な言語切り替えを可能にします。
5. プラットフォーム展開と日本市場におけるユースケース
Googleは、Gemini 3.5 Live Translateを単一の独立したソフトウェアとしてではなく、消費者向け(B2C)、エンタープライズ向け(B2B)、および開発者向け(B2D)のマルチチャネルを通じて垂直・水平展開しています。
モバイル環境と新機能「リスニングモード」
一般消費者向けには、iOSおよびAndroidの「Google翻訳」アプリの「会話モード」を通じてグローバル展開が開始されました。
アプリ内で任意のヘッドホンやイヤホンを装着するだけで、耳元で遅延の少ない同時通訳が流れる仕組みが構築されています。
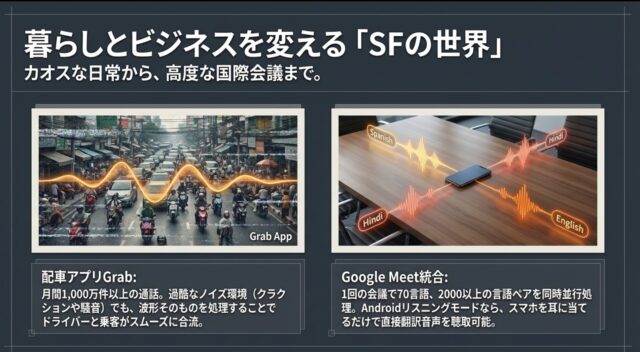
さらにAndroid版に先行導入された「リスニングモード(Listening Mode)」は、日常のUXにおける決定的な改善事例です。
このモードでは、イヤホンを持ち合わせていない状況や、周囲に翻訳音声を聞かれたくない状況において、通常の電話通話のようにスマートフォンを耳に当てるだけで、端末の上部レシーバー(受話口)から翻訳音声がプライベートにストリーミング再生されます。
例えば、海外旅行時のタクシー車内や現地の観光ツアーにおいて、イヤホンを装着し直す時間がない場面でも、自然にスマートフォンの受話部から翻訳結果を確認できる利便性を提供します。
なお、このリスニングモードは現時点でiOS版には対応していません。
Google Meetによるエンタープライズ改革
ビジネス領域における最大の適用事例は、オンラインビデオ会議ツールであるGoogle Meetへの統合です。
Meetにおける翻訳機能の進化は極めて劇的であり、従来はわずか5言語のみの対応、かつ「英語を介した翻訳」のみという極めて限定的な機能でした。
Gemini 3.5 Live Translateの導入により、この制限は以下のように大幅に拡張されました。
表2:Google Meetにおける音声翻訳機能の進化
| 機能項目 | 従来の仕様(2026年1月GA時点) | Gemini 3.5 Live Translate 統合後 |
|---|---|---|
| 対応言語数 | 5言語(英語、スペイン語、フランス語、ドイツ語、ポルトガル語) | 70言語以上 |
| 利用可能な言語ペア数 | わずか数ペア(常に英語が媒介となる制限あり) | 2,000通り以上の任意の言語ペア組み合わせ |
| 言語間媒介モデル | A言語 ⇔ 英語 ⇔ B言語(多段階処理による精度劣化) | 任意の言語から直接他言語へ双方向翻訳(中間言語不要) |
| ユーザーインターフェース | 設定ダイアログから事前に手動で有効化・設定する必要あり | 会議画面上にダイレクトにUI配置、即座にシームレス起動 |
| 話者の言語検出 | 事前固定が推奨(複数言語の混在に対応が困難) | 各話者の音声をバックグラウンドで自動言語検出、受動的に動作 |
この変革により、例えば日本の本社メンバーが日本語で、ブラジルの開発パートナーがポルトガル語で、フランスの営業メンバーがフランス語で同時に発言した場合でも、各自の言語設定に基づいて、背後で自動的に同時翻訳が実行されるワークフローが実現します。
6. 技術的限界、脆弱性、および安全性評価
革新的な性能を持つGemini 3.5 Live Translateですが、運用の安定性とハザード管理の観点から、Google自身もモデルカードや開発ドキュメントを通じて複数の既知の限界値を明確に開示しています。
音声合成とセッションの不安定性
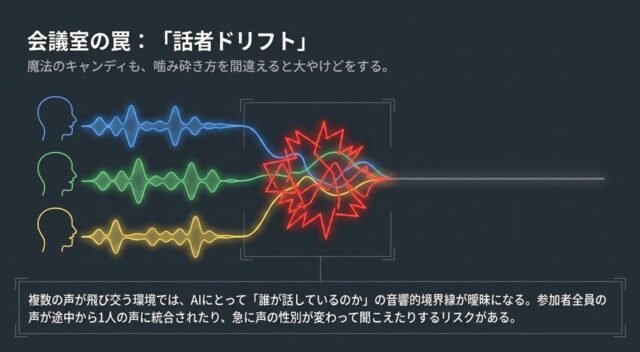
本モデルは、入力発話者の韻律特徴を翻訳音声に引き継ぐ「ボイスレプリケーション(声質の再現)」を試みますが、この機能は会話が長期化するか、同一セッション内に複数の話者が急激に入れ替わる状況下において動作が不安定になる傾向があります。
長時間の無音状態を挟むと合成音声のトーンが急変したり、会話開始時の短い第一声のみで話者のジェンダーを誤判定したまま固定化されたり、また発話者の入れ替わり速度に追従できず直前の話者の声質のまま翻訳を続けてしまう現象が報告されています。
環境騒音とエコー設定時の干渉
背景の雑音、路上ノイズ、音楽などの混入を遮断し、クリーンな音声ストリームを出力するためのノイズフィルタリング機能が実装されていますが、これらは完全ではありません。
特にAPIの設定でechoTargetLanguageをtrue(有効)にしている場合、ユーザーがターゲット言語で話している最中に、背後のノイズやBGMをモデルが「翻訳すべきインプット」と誤認してしまい、最終的な出力音声に不自然なグリッチ(ノイズ)や音響的なアーティファクト、ハウリングに似た音声障害を混入させる原因となります。
高度専門領域における翻訳ドリフト
本システムは一般的な会話文脈にきわめて強く、日常会話や標準的な観光・ビジネス調整は極めてスムーズに機能します。
しかし、法的な契約書審査、高度な医療診断の現場、極めて複雑な特許・エンジニアリング用語の飛び交うセッションにおいては、コンテキストの補正機能が十分に働かず、致命的な「翻訳ドリフト(誤訳)」やモデル独自のハルシネーション(もっともらしい誤情報の出力)が混入する懸念があります。
そのため、ビジネスにおける重大な意思決定局面では、書面での併記確認や人間のプロの通訳者による監視など、チェック体制が不可欠となります。
安全性評価とSynthIDによるウォーターマーキング
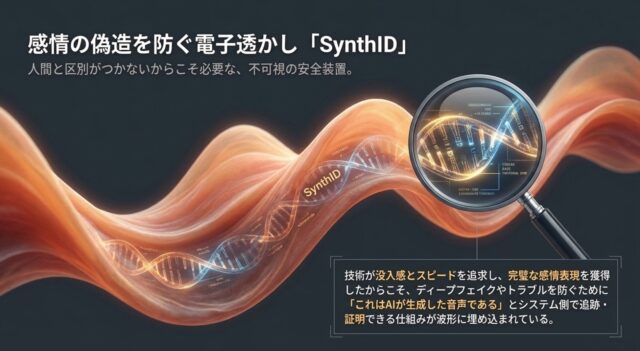
AIを用いたリアルタイム音声合成、とりわけ話者の声をシミュレートして別言語を話させる技術は、ディープフェイクや音声なりすましといった極めて深刻な安全保障上のリスクを内包します。
この課題に対応するため、Gemini 3.5 Live Translateが生成するすべてのオーディオストリームには、Google DeepMindの透かし技術である「SynthID」が標準でインテグレートされています。
SynthIDは、生成された音声波形の中に、人間の耳には全く検知できないレベルで特殊な識別シグナルを格子状に埋め込む技術です。
この透かしは、ノイズの混入、再録音、ビットレートの圧縮、あるいは部分的なトリミングといった音声の編集加工に対してもきわめて高い耐性を維持します。
これにより、下流の監視システムが音声をスキャンした際に、それがAIによって合成された「通訳音声」であるか、あるいは生身の人間が肉声で語ったものであるかを、確実かつ数学的に追跡・識別することが可能となり、規制産業やコンプライアンス要件が厳しいエンタープライズにおいても実用に足る信頼性を確保しています。
また、Googleの「フロンティア安全フレームワーク(Frontier Safety Framework)」に基づく評価プロセスでは、本モデルが従来のGemini 3.1 ProやGemini 3.7 Flash等と比較して、国家安全保障上のリスクに繋がるような新たな追跡対象・重要能力レベル(T/CCL)を自律的に獲得していないことが検証されており、クリティカル・ケイパビリティ・レベル(CCL)に到達する可能性は極めて低いと結論づけられています。
7. 競合比較分析
生成AIを基盤とするリアルタイム音声翻訳の領域では、主要プレイヤーによる熾烈なシェア獲得競争が発生しています。
表3:主要リアルタイム音声翻訳モデル・エンジン比較
| 評価項目 | Google Gemini 3.5 Live Translate | OpenAI GPT-Realtime-Translate | Soniox Speech Translation | Google TranslateGemma (オープンソース) |
|---|---|---|---|---|
| モデル提供形態 | クローズドAPI / クラウド製品統合 | クローズドAPI / プラットフォーム統合 | 専用ストリーミングAPI | オープンソース(ローカル・モバイル・クラウド) |
| 対応言語数 | 70以上の言語(自動検出) | 13の固定ターゲット言語 | 60以上の言語(自動検出) | 55言語 |
| 課金体系 | 音声時間による従量課金(約$2.21/時間相当) | 音声時間による従量課金(約$2.04/時間相当) | トークン課金(約$0.18〜0.88/時間相当) | 完全無料(自己インフラまたはデバイス上の実行コストのみ) |
| 同時通訳モード | 片方向ターゲット設定(セッションごと) | 片方向ターゲット設定(セッションごと) | 完全双方向マルチリンガル(単一WebSocket内) | オンデバイスまたはローカルバッチ |
| ソース言語の書き起こし | 同一ストリームで返されるが、最終確定時のみ出力 | Realtime Whisper(別モデル、追加課金)が必要 | 同一ストリーム内に完全統合、追加料金なし | なし(サードパーティ製STTモデルとの組み合わせが前提) |
| 評価メトリクス | AutoMQM、および内部レイテンシ・自然度評価 | 内部自動評価、人手評価 | 独自ストリーミングベンチマーク | 複数指標のコンセンサス(MetricX, AutoMQM, ChrF, 自然度) |
| オフライン・ローカル実行 | 非対応(クラウドWebSocket必須) | 非対応(クラウドAPI必須) | 非対応(クラウドAPI必須) | 対応(モバイル等のオンデバイス動作に最適化された4Bモデル等) |
各アプローチの強みと課題
GoogleのクローズドAPIモデルであるGemini 3.5 Live Translateは、70カ国以上の幅広いサポート言語、Googleの膨大な翻訳・音声合成インフラとの統合、そして何よりもGoogle TranslateアプリやGoogle Meetといった数億人のアクティブユーザーを抱えるプラットフォーム上に標準機能として組み込まれている点で、極めて高い優位性を持ちます。
これに対し、OpenAIのGPT-Realtime-Translateはボイスエージェントとしての汎用性を重視するものの、翻訳出力が13言語という少数の主要ターゲット言語に制限されている点がボトルネックです。
また、独立系専門プロバイダーであるSonioxは、1つのWebSocketセッション内で双方向の通訳処理(AからB、BからA)を同時にハンドリングできる先進的なプロトコルと、極めて破壊的なコスト競争力(GoogleやOpenAIの約10分の1)を武器に差別化を図っています。
さらに注目すべきなのは、Googleがオープンモデル戦略の一環として公開したTranslateGemmaスイートの存在です。
Gemma 3をベースに構築されたこのオープンな翻訳モデルは、55言語をサポートし、モバイルデバイス等のローカル環境(特に4Bサイズモデル)やRaspberry Piのようなオフライン環境でも動作するよう高度に最適化されています。
TranslateGemmaは、API利用料のコストやパブリッククラウドへの機密データ転送(プライバシーリスク)を懸念する開発者にとって強力な代替選択肢となっています。
このオープンソース群の評価プロセスにおいて、Googleは単一の指標ではなく、MetricX、AutoMQM、ChrF、さらに自然度などを組み合わせた多角的アンサンブル評価(複数モデルの合意形成手法)を採用し、オープン環境での精度担保に成功しています。
8. 結論と将来展望
Gemini 3.5 Live Translateは、学術研究や時折のコンセプト実証レベルに留まっていた「AIリアルタイム通訳」を、実用に足る日常的・実務的なコミュニケーション基盤へと引き上げました。
テキストを仲介しないネイティブ音声対音声のパラダイムは、単なる応答時間の短縮のみならず、言葉のニュアンス、感情、話者の人間性を伝える「韻律情報の保持」という、コミュニケーションにおいて最も重要な非言語要素をデジタル翻訳に組み込むことに成功しました。
短期的には、言語の壁によって事実上単一言語圏に固定されていたカスタマーサポート窓口や多国籍企業の意思決定会議が、本モデルの導入により急激に脱・英語化(De-Anglicization)され、真のマルチリンガル・アプローチへと再構築されると考えられます。
開発者が自身のアプリケーション、WebRTCインフラ、および顧客管理システムにこのAPIを組み込む動きは、パートナーであるAgoraやLiveKit等の活発な支援体制と相まって急速に進む見通しです。
長期的には、この技術の進化系がウェアラブルデバイスやスマートグラス、高機能イヤホン等の極小オンデバイスに完全ローカル統合される未来を予見させます。
TranslateGemmaのような軽量かつ高性能なローカルオープンモデルの躍進と、Gemini 3.5 Live Translateのような超高精度クラウドモデルのハイブリッド利用は、インフラのない極地や通信規制の厳しい領域における言語障壁すらも事実上消失させるでしょう。
言葉が発せられた瞬間、自動的に別の言語となって相手の耳に届く「SF映画のような万能翻訳機」の世界は、すでに一過性の技術予測ではなく、実用的なエンタープライズの現実として市場に実装され始めています。
